
2
Minuten Lesezeit
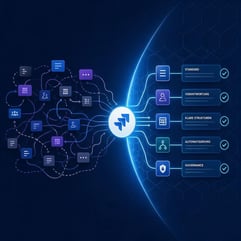
Greenfield IT-Service mit KI: Wie die BAS Group ihre internationalen IT-Prozesse transformierte
HanseVision begleitete die BAS Group bei der Umsetzung einer Greenfield-IT-Service-Lösung auf Basis von Atlassian, modular aufgebaut, skalierbar und perfekt auf die Bedürfnisse internationaler Teams zugeschnitten.
8
Minuten Lesezeit
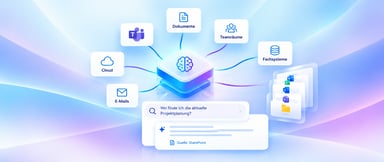
SharePoint Admin Agent: In 7 Schritten zu einer KI-fähigen SharePoint-Umgebung
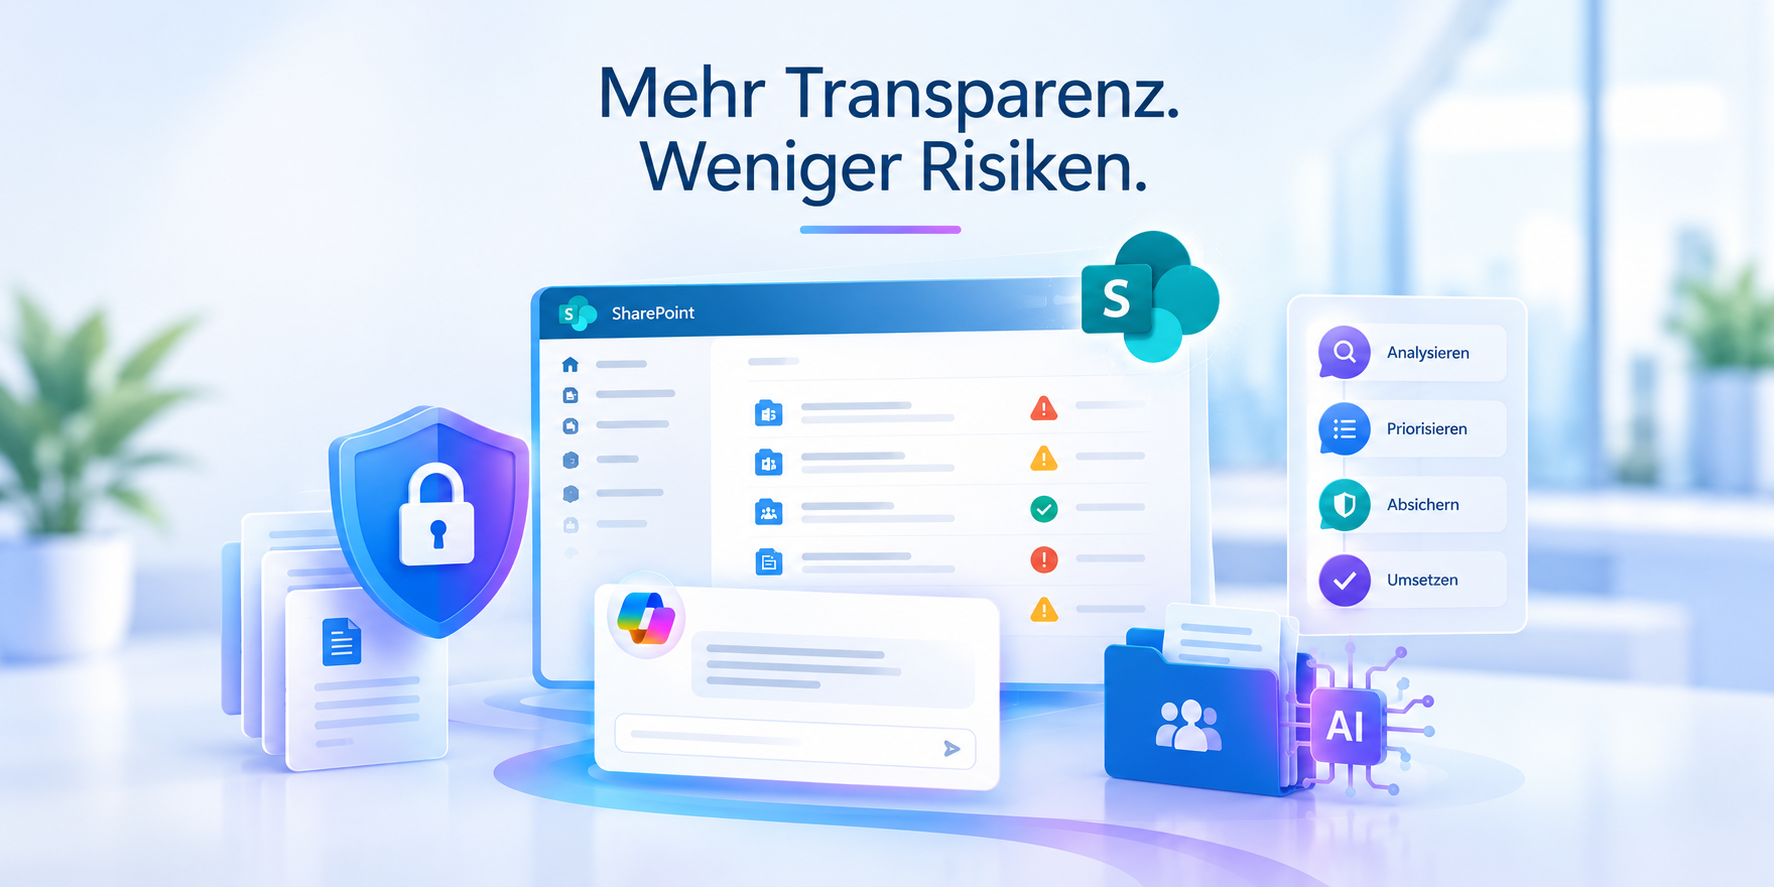
Eine Excel-Datei aus der Personalabteilung, die seit 2019 für „Alle außer externen Benutzern“ freigegeben ist. SharePoint-Sites ohne verantwortliche Eigentümer. Sensibilitätsbezeichnungen, die zwar konzipiert, aber nie konsequent umgesetzt wurden. Solche Altlasten sind in gewachsenen Microsoft-365-Umgebungen keine Seltenheit. Solange Mitarbeitende Informationen manuell suchen, bleiben problematische Berechtigungen oder veraltete Inhalte häufig unentdeckt. Mit Microsoft 365 Copilot verändert sich das: Informationen lassen sich einfacher finden und zusammenführen. Damit steigt auch die Bedeutung einer sauberen Berechtigungsstruktur und einer durchdachten Governance. Copilot verursacht das Berechtigungschaos nicht. Er macht dessen Auswirkungen sichtbarer. Genau hier setzt der SharePoint Admin Agent an. Er unterstützt Administratoren dabei, Risiken in SharePoint und OneDrive systematisch zu identifizieren und daraus konkrete Maßnahmen abzuleiten.
3
Minuten Lesezeit
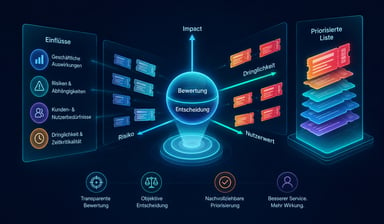
Große Veränderungen werden nicht ausgerollt, sondern validiert
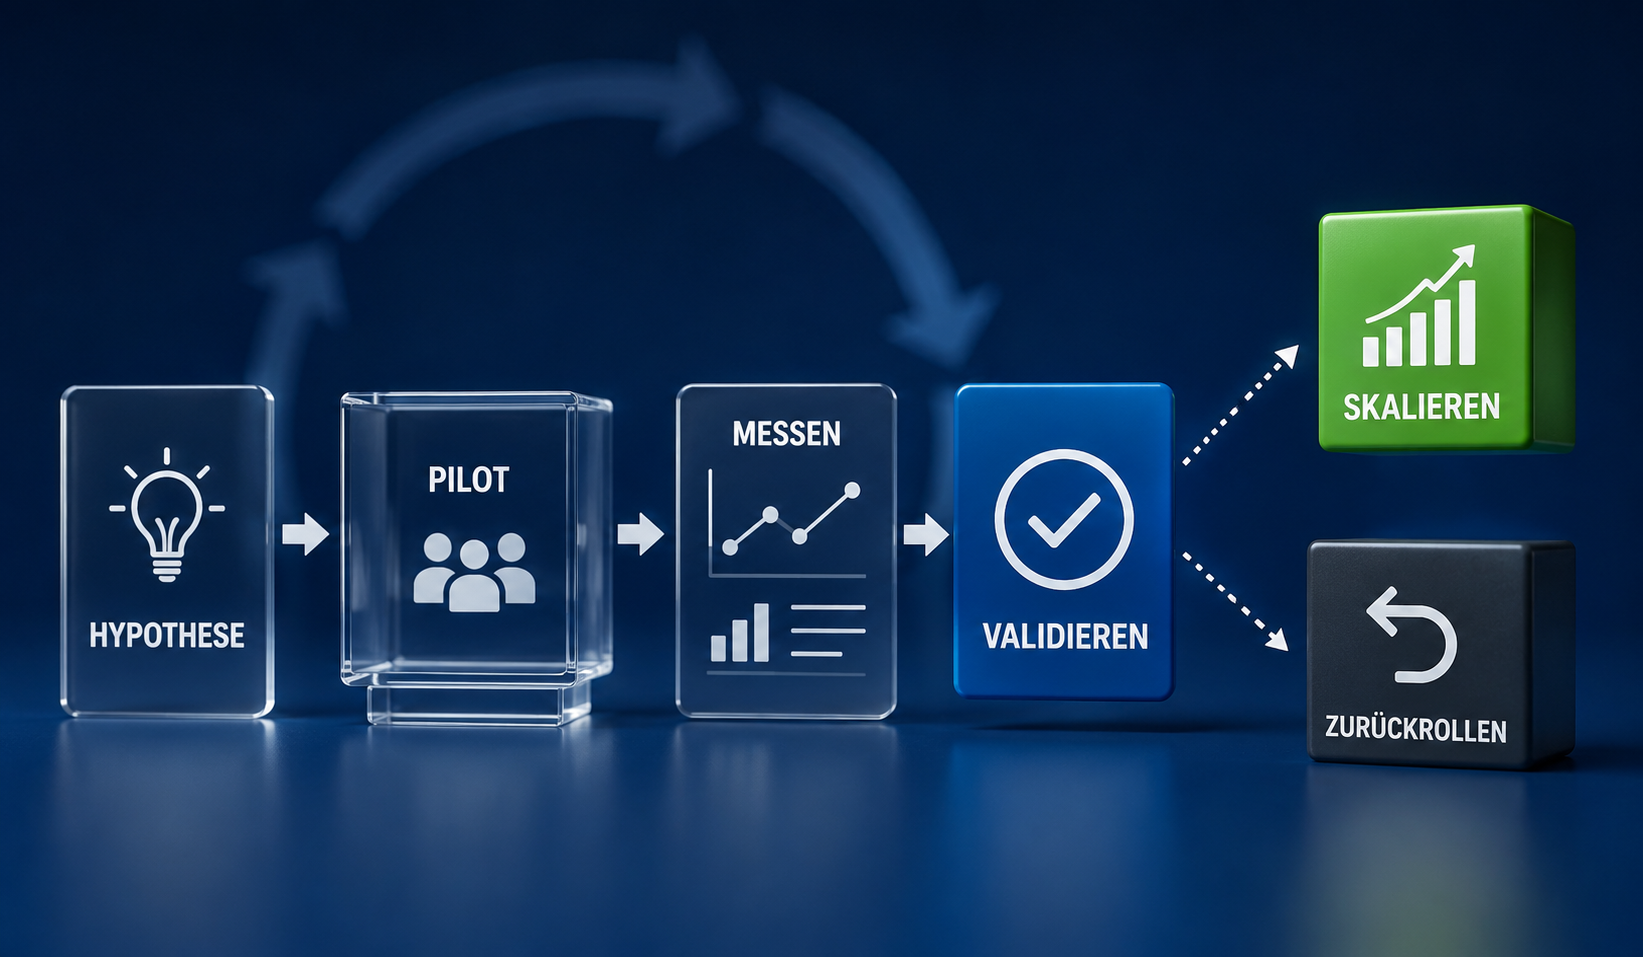
Das eigentliche Problem Veränderungen brauchen Hypothesen, Messgrößen und kontrollierte Experimente. Diese Prinzipien sind nicht neu. Sie gelten seit Jahrzehnten in Produktentwicklung, Qualitätsmanagement und Prozessmanagement: Hypothese formulieren, pilotieren, messen, Feedback einholen, bei Bedarf zurückrollen, kontrolliert skalieren. Keiner dieser Schritte ist an eine bestimmte Technologie gebunden. Trotzdem werden sie bei großen Veränderungen regelmäßig übersprungen. Der Grund ist selten Unwissen, sondern Druck. Ein Zieltermin steht, eine Entscheidung ist gefallen, der Prozess soll ab Montag laufen. Ob die Änderung überhaupt das Richtige bewirkt, wird erst gefragt, wenn die Beschwerden eintreffen. Verkündung oder Experiment Der Unterschied zwischen einer riskanten und einer belastbaren Einführung liegt nicht in der Technologie, sondern in der Haltung dahinter. Wird die Änderung verkündet oder wird sie validiert? Die verkündete Variante sieht so aus: Der Incident-Prozess wird komplett umgebaut, am Montag geht die neue Fassung für alle Teams live. Kein Referenzwert, keine Vergleichsgruppe, kein definierter Punkt, an dem sich zeigt, ob die Änderung wirkt oder schadet. Fällt etwas auf, ist bereits der gesamte Betrieb betroffen. Dieselbe Logik wiederholt sich bei jeder Automatisierung, die sofort für 15.000 Tickets scharf geschaltet wird, statt zuerst an einem Pilotbereich. Die validierte Variante führt denselben Prozess zunächst in einem Team ein, misst Durchlaufzeiten, SLA-Einhaltung, Rückfragen und Kundenzufriedenheit und skaliert erst, wenn die Zahlen die Annahme bestätigen. Der Aufwand ist höher, das Risiko ungleich kleiner. Was vor dem Rollout zu klären ist 1. Hypothese benennen: Welche messbare Verbesserung soll die Änderung bewirken, und woran wird sie erkennbar? 2. Ausschnitt festlegen: An welchem Team, Bereich oder Ticketvolumen wird zuerst geprüft, bevor breit ausgerollt wird? 3. Messgrößen definieren: Welche Kennzahlen entscheiden über Skalierung oder Rückbau, und wer bewertet sie? 4. Rückfallpfad sichern: Wie sieht der Weg zurück aus, wenn die Zahlen die Annahme widerlegen? Diese vier Fragen sind unabhängig davon, ob ein Serviceprozess in Jira Service Management umgebaut, eine Migration nach Atlassian Cloud geplant, ein neuer Confluence-Bereich eingeführt oder eine Automatisierung in Jira aktiviert wird. Die Werkzeuge wechseln, die Methode bleibt. Change Management & Adoption entscheidet, nicht der Go-live Selbst eine technisch saubere Einführung scheitert, wenn die Menschen sie nicht annehmen. Ein typisches Muster: Ein neues Serviceportal geht live, technisch einwandfrei, aber Wochen später laufen die meisten Anfragen weiterhin per E-Mail und Zuruf an einzelne Bearbeiter. Im System sieht die Einführung erfolgreich aus, im Alltag hat sich nichts verändert. Solche Fälle fallen erst auf, wenn man tatsächliche Nutzung misst und nicht bloße Verfügbarkeit. Wirkung entsteht erst, wenn eine Änderung im realen System of Work der Teams ankommt, in den Abläufen, in denen täglich gearbeitet wird. Nutzungsgrad, Anteil der am Prozess vorbei gelösten Vorgänge und Rückfragen zur Bedienung gehören deshalb in denselben Pilot wie die Durchlaufzeiten. Adoption ist keine Kommunikationsmaßnahme nach dem Go-live, sondern eine Messgröße wie jede andere. Die Rolle von KI KI ist nur das aktuellste Beispiel dafür, was passiert, wenn diese Prinzipien fehlen. Sie macht schlechte Prozesse nicht gut. Sie macht sie schneller. Wer eine unklare Statuslogik oder eine ungeprüfte Priorisierungsregel automatisiert, skaliert nicht die Verbesserung, sondern den Fehler. KI entfaltet ihren Wert erst auf einem Basisprozess, dessen Wirkung vorher an einem kleinen Ausschnitt gemessen wurde. Damit schließt sich der Kreis zum Kundenservice, mit dem dieser Text beginnt. Derselbe Kundenservice, der bei einem unkontrollierten Rollout kippt, läuft auf einem validierten Prozess stabil. Ob er dabei auf Jira Service Management mit seinen Funktionen für Customer Service Management aufsetzt oder auf einer anderen Plattform, ist die zweite Frage, nicht die erste. Nicht das Produkt entscheidet über die Servicequalität, sondern der Prozess, auf dem es betrieben wird. Eine Änderung ohne Hypothese, ohne Messpunkt und ohne Rückfallpfad ist kein Rollout. Sie ist eine Wette. Eine strukturierte Betriebsbewertung zeigt, wo Veränderungen heute verkündet statt validiert werden und welche davon das größte Risiko tragen. Governance & Operating Check: Kontakt
Alle Artikel
7
Minuten Lesezeit